
Bài Toán TCO 2026: Nên Mua Server AI Hay Thuê Cloud GPU?
Hạ tầng Server AI On-Premise rẻ hơn thuê Cloud GPU khi doanh nghiệp duy trì mức sử dụng GPU trên khoảng 40% – 77%, và đắt hơn khi máy chạy dưới ngưỡng đó. Báo cáo TCO của Lenovo chỉ ra rằng với các khối lượng workload suy luận (Inference) chạy liên tục, hạ tầng tự sở hữu có thể hòa vốn trong chưa đầy 4 tháng và rẻ hơn tới 17 lần tính trên mỗi triệu token so với thuê API. Ngược lại, GPUSmith ghi nhận phần lớn tổ chức lần đầu đo utilization thực tế chỉ đạt 35% – 55% — vùng mà dịch vụ Cloud GPU vẫn chiếm ưu thế về mặt chi phí. Bài viết này tổng hợp số liệu kỹ thuật thực tế từ hai phía để doanh nghiệp tự tính toán bài toán chi phí cho hạ tầng máy tính của mình tại Sicomp.
Server AI On-Premise là gì?
Server AI On-Premise là máy chủ trang bị các bộ xử lý đồ họa tăng tốc AI chuyên dụng (NVIDIA H200, B200, RTX PRO 6000 Blackwell, L40S...) do doanh nghiệp trực tiếp mua sắm và đặt tại văn phòng hoặc thuê chỗ đặt tại Data Center, thay vì thuê hạ tầng theo giờ từ các nhà cung cấp đám mây. Doanh nghiệp chi trả chi phí đầu tư ban đầu một lần và khai thác liên tục trong vòng đời từ 3 đến 5 năm.
Ưu thế lớn nhất của Server AI On-Premise nằm ở quyền kiểm soát toàn diện dữ liệu - yếu tố bắt buộc đối với các tổ chức tài chính, y tế, ngân hàng hoặc doanh nghiệp sở hữu hồ sơ nội bộ nhạy cảm không được phép đưa lên hạ tầng của bên thứ ba. Theo tài liệu phân tích từ Lenovo Press, thị trường 2026 đã chính thức chuyển từ giai đoạn thử nghiệm sang Inference công nghiệp - vận hành mô hình liên tục ở thông lượng cao. Chính sự dịch chuyển này khiến bài toán TCO nghiêng hẳn về phương án On-Premise đối với các khối lượng công việc chạy ổn định.
Giá thuê Cloud GPU năm 2026 bao nhiêu?
Mặt bằng giá thuê GPU Cloud đã hạ nhiệt đáng kể: AWS thực hiện cắt giảm 44% giá H100 trên dòng instance P5 từ giữa năm 2025 (từ mốc ~7.57 USD xuống ~3.90 USD/GPU-giờ), kéo theo làn sóng điều chỉnh giá từ GCP và Azure (theo GPUSmith, 11/07/2026). Tham khảo bảng chi phí Cloud GPU trung bình năm 2026:
| Model GPU | Dung lượng VRAM | Giá On-Demand (/giờ) | Ước tính (/GPU/tháng - 730h) |
|---|---|---|---|
| NVIDIA H100 SXM | 80GB HBM3 | 2.00 – 4.50 USD | 1.460 – 3.285 USD |
| NVIDIA H200 | 141GB HBM3e | 3.50 – 6.00 USD | 2.555 – 4.380 USD |
| NVIDIA A100 | 80GB HBM2e | 0.90 – 2.50 USD | 657 – 1.825 USD |
| NVIDIA L40S | 48GB GDDR6 | 0.40 – 1.20 USD | 292 – 876 USD |
Nguồn dữ liệu tham chiếu: VRLA Tech (03/04/2026) & GPUSmith (11/07/2026).
Lưu ý: Một hệ thống 4× H100 On-Demand ngốn khoảng 5.840 – 13.140 USD/tháng, chưa bao gồm chi phí lưu trữ SSD, băng thông và phí chuyển dữ liệu ra ngoài (Egress Fee). Dạng giá Spot Instance rẻ hơn 60% – 70% nhưng có thể bị thu hồi ngắt quãng đột ngột, hoàn toàn không phù hợp cho các dịch vụ yêu cầu độ sẵn sàng (Uptime) cao.
Khi nào Server AI On-Premise rẻ hơn Cloud GPU?
Biến số quyết định hiệu quả tài chính là Utilization, tỷ lệ thời gian phần cứng GPU thực sự tham gia tính toán. Theo tổng hợp các nghiên cứu TCO từ GPUSmith, điểm hòa vốn của phương án On-Premise nằm ở mức 40% – 77% Utilization duy trì. Khi hiệu suất khai thác vượt quá mốc này, tự sở hữu máy chủ chắc chắn rẻ hơn; nếu dưới mốc này, thuê Cloud GPU sẽ tối ưu dòng tiền hơn.
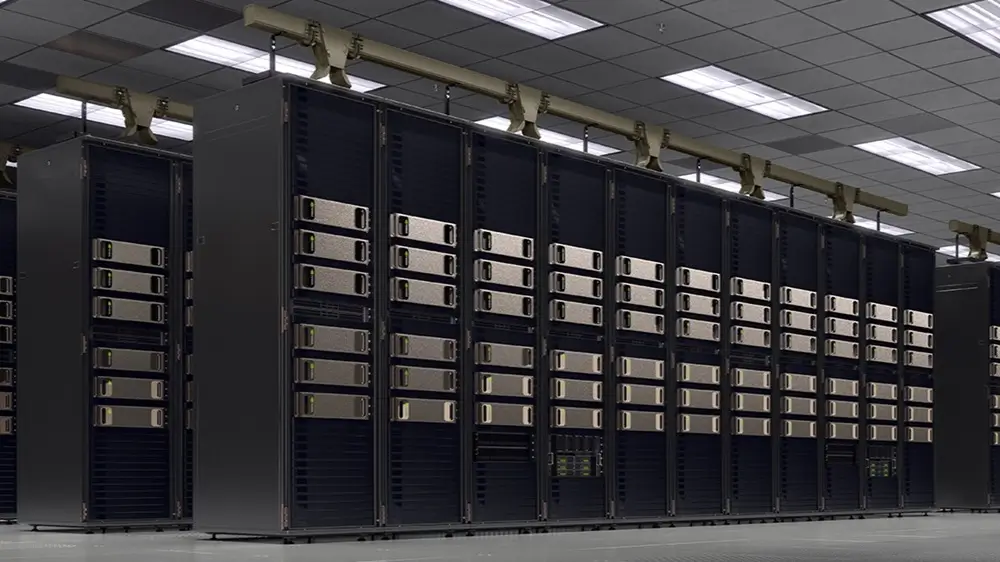
Các con số thực tế chứng minh ưu thế của On-Premise đối with workload chạy ổn định:
- Điểm hòa vốn dưới 4 tháng: Lenovo tính toán các hệ thống tự sở hữu chạy workload Utilization cao có thể hoàn vốn trong vòng chưa đầy 4 tháng. Chi phí tính trên mỗi triệu token xử lý thấp hơn tới 17 lần so with việc thuê Model-as-a-Service API trong vòng đời 5 năm.
- Phép tính thuê 4 năm: VRLA Tech tính toán một cụm 4× H100 Cloud ở mức giá ưu đãi vẫn tốn khoảng 70.000 USD/năm — tương đương gần 280.000 USD sau 4 năm mà doanh nghiệp không sở hữu bất kỳ tài sản vật lý nào.
- Định ngưỡng theo Token: Tự host Server AI On-Premise bắt đầu rẻ hơn gọi API đóng (như ChatGPT, Claude) khi lượng dữ liệu xử lý chạm ngưỡng từ 2 – 5 triệu token/ngày.
Các chi phí ẩn khiến On-Premise đắt hơn dự tính
Phép tính đơn giản "giá mua phần cứng ÷ giá thuê theo giờ" thường bỏ qua các khoản chi phí vận hành thực tế. Ba nhóm chi phí ẩn chính theo GPUSmith bao gồm:
- Chi phí vận hành: Chiếm thêm 20% – 30% giá trị phần cứng mỗi năm dành cho nhân sự quản trị hệ thống, cập nhật driver, xử lý sự cố và giám sát 24/7. Đây là khoản chi phí mà các doanh nghiệp SMB (13–50 nhân sự) rất hay bỏ qua.
- Điện năng, tản nhiệt và chỗ đặt: Tổng chi phí TCO trong 3 năm của một node 8× H100 On-Premise dao động từ 590.000 – 900.000 USD (đã tính tiền điện, hạ tầng làm mát), so with 735.000 – 814.000 USD thuê On-Demand — khoảng cách chênh lệch thực tế hẹp hơn nhiều so with tính toán ban đầu.
- Khấu hao công nghệ: NVIDIA duy trì chu kỳ ra mắt kiến trúc GPU mới khoảng 2 năm/lần. Cam kết 3–5 năm with một thế hệ phần cứng đồng nghĩa với việc vào cuối vòng đời, cỗ máy sẽ chậm hơn từ 1 đến 2 thế hệ công nghệ mới.
Ngược lại, Cloud GPU cũng tồn tại chi phí ẩn: Phí chuyển dữ liệu ra ngoài của AWS khoảng 0.09 USD/GB đối with dung lượng trên 10TB/tháng. Việc xuất 1PB dữ liệu ra khỏi Cloud một lần có thể ngốn tới 92.000 USD. Do đó, các doanh nghiệp có tệp dữ liệu lớn, ra vào liên tục nên tính toán kỹ yếu tố này.
Doanh nghiệp SMB nên bắt đầu với cấu hình Server AI nào?
Xây dựng Server AI On-Premise không bắt buộc phải đầu tư ngay các dòng card đắt đỏ như H200 hay B200. Đối with các bài toán suy luận (Inference) và fine-tune mô hình mã nguồn mở cỡ vừa, dòng card máy trạm chuyên dụng như NVIDIA RTX PRO 6000 Blackwell (96GB GDDR7 VRAM) là điểm khởi đầu tối ưu:
| Cấu hình Server AI | Tổng dung lượng VRAM | Năng lực gánh bài toán AI |
|---|---|---|
| 1× RTX PRO 6000 Blackwell | 96GB GDDR7 ECC | Inference model 32B FP16, Fine-tune QLoRA model 70B |
| 2× RTX PRO 6000 Blackwell | 192GB GDDR7 ECC | Inference model 70B FP16 không cần quantize |
| 4× RTX PRO 6000 Blackwell | 384GB GDDR7 ECC | Fine-tune LoRA/QLoRA model 70B+, gánh đa luồng nhiều user |
Lộ trình triển khai thực dụng cho doanh nghiệp SMB:
1. Đo lường chỉ số Utilization thực tế trong 2–3 tháng trên hạ tầng Cloud hoặc API.
2. Nếu Utilization duy trì vượt 50% hoặc lượng dữ liệu chạm mốc 2–5 triệu token/ngày, tiến hành lập bài toán TCO chuyển sang On-Premise.
3. Bắt đầu khởi điểm with 1–2 card RTX PRO 6000 96GB hoặc L40S 48GB, sau đó mở rộng theo quy mô thay vì đầu tư ngay lập tức cụm 8 GPU.
Những sai lầm phổ biến khi ra quyết định On-Premise vs Cloud
- Chỉ so sánh giá mua phần ứng with giá thuê theo giờ: Bỏ quên 20%–30%/năm chi phí vận hành, tiền điện và hạ tầng làm mát.
- Quyết định theo cảm tính sợ lộ dữ liệu: Không phân định rõ đâu là dữ liệu bảo mật bắt buộc On-Premise, đâu là dữ liệu công khai có thể chạy Cloud.
- Mua Server AI khi Utilization dưới 40%: Chi trả CapEx đắt đỏ cho một hệ thống phần cứng nằm chờ không khai thác hết công suất.
- Duy trì ở lại Cloud khi workload đã chạy đều 24/7: Chi trả mức phí thuê cao gấp nhiều lần so with chi phí sở hữu thực tế trong dài hạn.
Câu Hỏi Thường Gặp (FAQ)
1. Server AI On-Premise là gì?
Là máy chủ trang bị GPU tăng tốc AI do doanh nghiệp tự mua sắm, đặt tại chỗ hoặc thuê chỗ đặt (colocation), trả chi phí đầu tư ban đầu (CapEx) một lần thay vì thuê theo giờ từ Cloud, giúp toàn quyền kiểm soát dữ liệu và phần cứng.
2. Khi nào nên mua Server AI thay vì thuê Cloud GPU?
Khi tỷ lệ GPU Utilization duy trì vượt khoảng 40% – 77% (theo GPUSmith) hoặc khối lượng xử lý vượt mốc 2 – 5 triệu token/ngày. Workload chạy ổn định 24/7 có thể hoàn vốn trong dưới 4 tháng theo báo cáo của Lenovo.
3. Chạy mô hình AI 70B On-Premise cần bao nhiêu VRAM?
Inference FP16 nguyên bản không quantize cần khoảng 384GB VRAM — tương đương 4× card RTX PRO 6000 Blackwell 96GB. Nếu chấp nhận nén lượng tử hóa 4-bit (quantize Q4), yêu cầu VRAM giảm xuống còn khoảng 1/4 (~48GB–64GB).
4. Chi phí ẩn lớn nhất của On-Premise là gì?
Là chi phí vận hành OpEx chiếm 20% – 30% giá trị phần cứng mỗi năm (nhân sự quản trị, driver, giám sát) và rủi ro khấu hao công nghệ khi NVIDIA ra mắt kiến trúc GPU mới theo chu kỳ ~2 năm/lần.
5. Dịch vụ Cloud GPU có chi phí ẩn không?
Có — điển hình là phí xuất dữ liệu ra ngoài (Egress Fee) khoảng 0.09 USD/GB (AWS): việc chuyển 1PB dữ liệu ra khỏi Cloud một lần có thể tốn tới khoảng 92.000 USD.
Tổng Kết
Đừng hỏi "On-Premise hay Cloud cái nào rẻ hơn" — hãy hỏi "Chỉ số Utilization thực tế của doanh nghiệp là bao nhiêu". Nếu dưới 40%: duy trì ở lại Cloud/API. Nếu đạt 50% – 60% duy trì và có yêu cầu kiểm soát dữ liệu: On-Premise chắc chắn tối ưu chi phí hơn trong 3–5 năm, with thời gian hòa vốn dưới 4 tháng. Doanh nghiệp SMB nên bắt đầu khởi điểm with 1–2 GPU RTX PRO 6000 96GB thay vì mua sắm tràn lan.
Quý doanh nghiệp cần tư vấn cấu hình Server AI theo đúng bài toán workload và ngân sách thực tế? Hãy liên hệ ngay with đội ngũ kỹ sư của Sicomp qua hotline 0384.734.666 để nhận báo giá TCO 5 năm minh bạch và tối ưu nhất hôm nay!
Bài viết liên quan
5600X3D ra mắt: lựa chọn rất tốt trong thời điểm gần cuối 2026
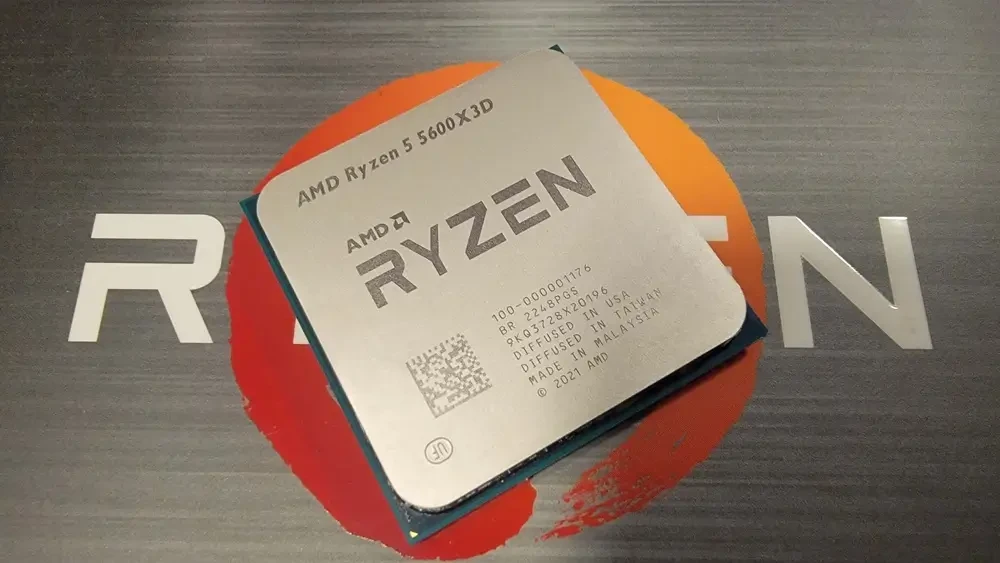
Nền tảng Socket AM4 của AMD tiếp tục đưa ra các sản phẩm mới hỗ trợ cho các cá nhân đang muốn nâng cấp cho PC cũ của mình. Mặc dù AM5 đã phổ biến, việc AMD bổ sung các dòng vi xử lý tích hợp công nghệ bộ nhớ đệm xếp chồng 3D V-Cache xuống phân khúc phổ thông như AMD Ryzen 5 5600X3D mang lại một con đường nâng cấp kinh tế hoàn hảo cho game thủ và người dùng đang sở hữu các đời mainboard AM4 cũ. Sở hữu 6 nhân 12 luồng xử lý, tiến trình 7nm TSMC cùng bể chứa bộ nhớ đệm L3 Cache khổng lồ lên tới 96MB, con chip này sẽ là một lựa chọn tốt trong các tựa game eSports mà không đòi hỏi người dùng phải bỏ ra quá nhiều tiền cho 5700X3D. Sicomp sẽ phân tích chiếc CPU này, để chúng ta cùng hiểu tại sao AMD lại phải sản xuất ra chiếc CPU này.
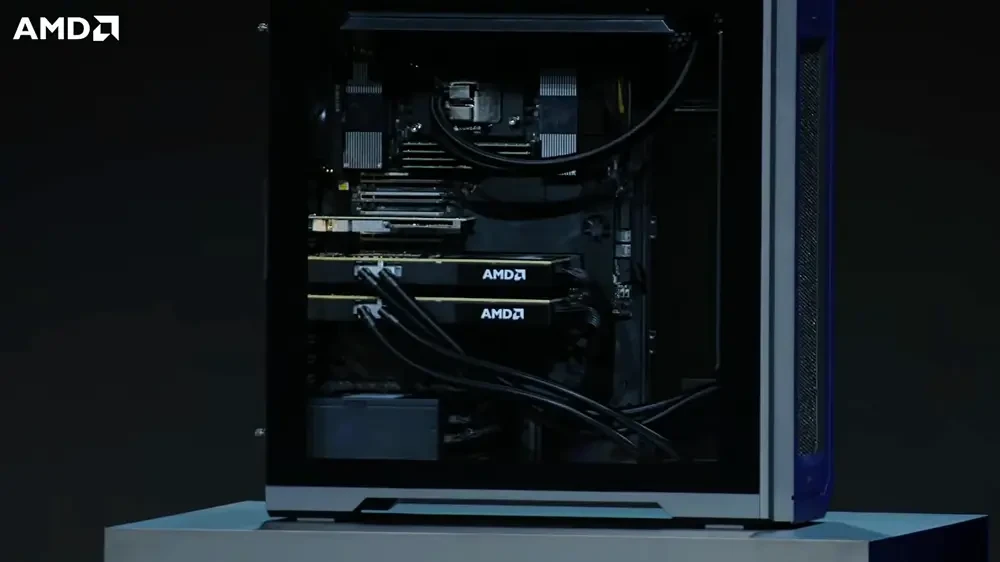
AMD giới thiệu máy workstation Halo Station với tổng VRAM lên đến 576GB
Tại sự kiện công nghệ IFA 2026 tại Berlin, AMD đã làm chấn động toàn bộ ngành công nghiệp phần cứng khi chính thức vén màn siêu cỗ máy mang tên Threadripper Halo Station, được Phó chủ tịch cấp cao Jack Huynh khẳng định là "máy trạm cá nhân mạnh nhất thế giới hiện nay".
Bo Mạch Chủ Có Thể Tăng Giá Do Chi Phí Linh Kiện Tăng
Thị trường linh kiện phần cứng máy tính chuẩn bị bước vào một chu kỳ biến động giá mới khi chi phí nguyên vật liệu sản xuất bo mạch chủ (mainboard) ghi nhận mức tăng kỷ lục từ 10% đến 50%. Theo báo cáo từ chuỗi cung ứng Board Channels, chi phí danh mục vật liệu (BOM) sản xuất bo mạch chủ đã tăng tổng thể ít nhất 10%, trong khi mức điều chỉnh giá bán lẻ mà các hãng áp dụng ra thị trường trong tháng 8 vừa qua chỉ mới bù đắp được khoảng 3%. Sự chênh lệch lớn này cho thấy các nhà sản xuất lớn như ASUS, GIGABYTE, MSI đang chịu áp lực biên lợi nhuận đè nặng và một đợt tăng giá trên diện rộng trong Quý 3 và Quý 4 năm 2026 là điều khó tránh khỏi. Bài viết phân tích từ đội ngũ chuyên gia của Sicomp sẽ bóc tách chi tiết các tác nhân đẩy giá và đưa ra lời khuyên mua sắm tối ưu nhất cho người dùng.
Cách Chọn & Kiểm Tra Trước Khi Mua RAM RDIMM DDR5 64GB 6400
Từ đầu năm 2026, các nhà cung cấp dịch vụ đám mây và các nhà sản xuất máy chủ OEM đã đồng loạt dịch chuyển đơn đặt hàng từ module 96GB và 128GB xuống module 32GB và 64GB, trong khi giá hợp đồng server DRAM quý 3/2026 được dự báo tăng 13–18% so với quý trước (theo TrendForce, 09/07/2026). Hai chuyển động của thị trường gặp nhau ở một điểm: RAM RDIMM DDR5 64GB 6400. Chọn đúng một thanh 64GB tốc độ 6400 MT/s phụ thuộc trực tiếp vào ba yếu tố: cách tổ chức chip nhớ (x4 hay x8), nền tảng của bạn có chạy nổi xung nhịp 6400 ở cấu hình sắp cắm hay không, và module đó đã vượt qua kiểm định QVL của ai. Bài viết này Sicomp sẽ đi qua cả ba vấn đề cốt lõi, kèm bảng tra cứu để bạn kiểm tra chính xác trước khi mua.