
NVIDIA DGX Spark: chọn cho ai và cách nối cluster
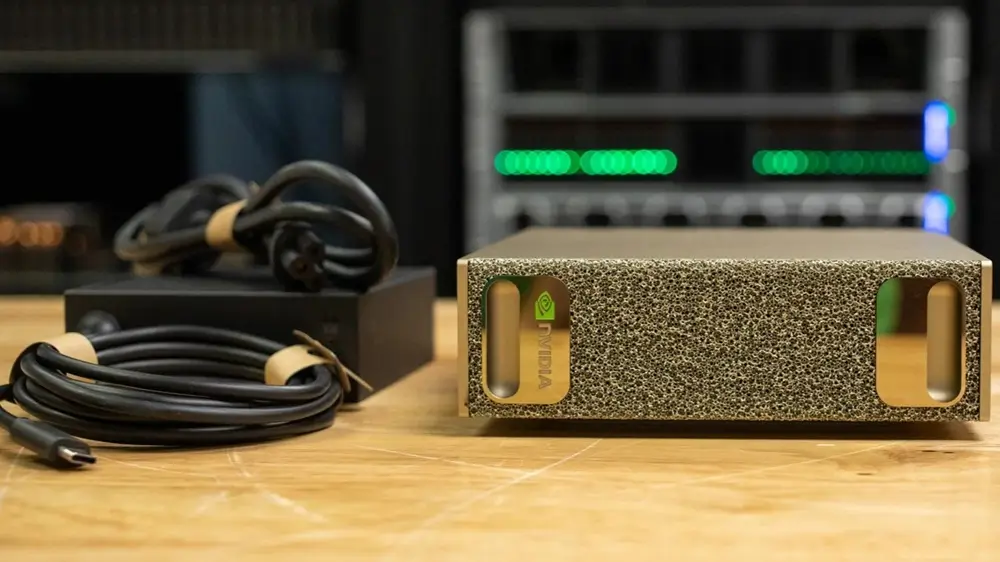
NVIDIA DGX Spark là máy tính AI để bàn chạy siêu chip GB10 Grace Blackwell, cung cấp tối đa 1 PetaFLOP hiệu năng FP4 và 128GB bộ nhớ hệ thống hợp nhất (unified memory), đủ để chạy suy luận (Inference) các mô hình ngôn ngữ lớn (LLM) tới 200 tỷ tham số ngay tại bàn làm việc. Khi ghép nối hai máy qua card mạng ConnectX-7, con số đó nâng lên mốc 405 tỷ tham số. Nhưng trước khi quyết định xuống tiền đầu tư, có một thông số trên bảng đặc tả kỹ thuật quan trọng hơn tất cả những con số vừa nêu — và nó không nằm ở dòng nào được in đậm. Bài viết này từ đội ngũ kỹ sư của hệ thống Sicomp sẽ phân tích số liệu thực tế, chỉ rõ máy hợp với ai, không hợp với ai, và hướng dẫn từng bước kết nối cluster theo đúng chuẩn tài liệu kỹ thuật của NVIDIA.
I. NVIDIA DGX Spark là gì và mạnh đến đâu?
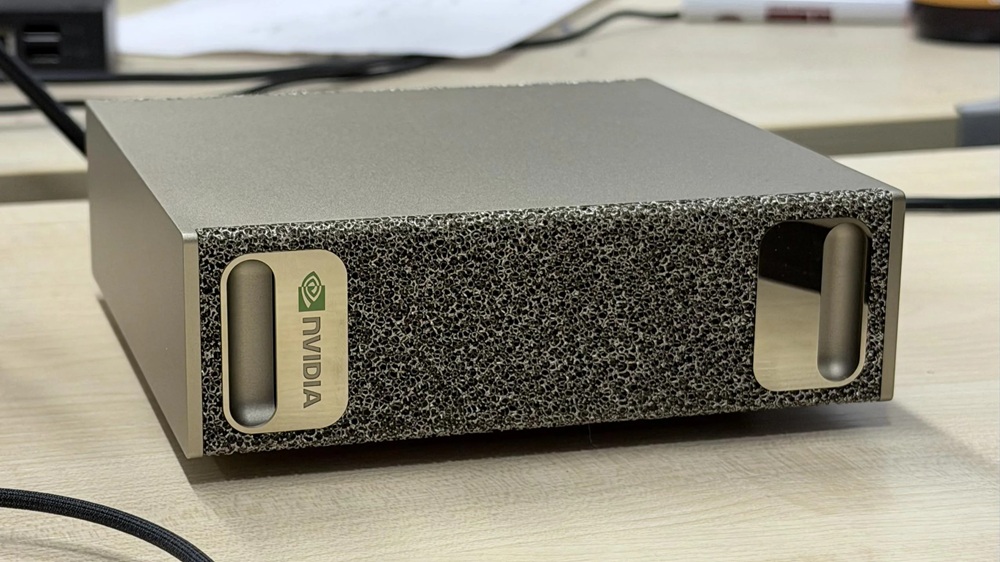
NVIDIA DGX Spark là hệ thống AI để bàn hoàn chỉnh của NVIDIA, dựng quanh siêu chip GB10 Grace Blackwell. Máy nặng 1,2 kg, kích thước siêu nhỏ gọn 150 × 150 × 50,5 mm, bộ nguồn adapter 240W — nhỏ hơn một chồng sách giáo khoa và cắm vừa mọi ổ điện văn phòng dân dụng.
Bảng thông số đặc tả kỹ thuật chính thức từ trang sản phẩm NVIDIA:
| Hạng mục phần cứng | Thông số đặc tả kỹ thuật |
|---|---|
| Kiến trúc Superchip | NVIDIA Grace Blackwell (GB10) |
| Khối CPU Arm | 20 nhân Arm (10 Cortex-X925 + 10 Cortex-A725) |
| Khối GPU & Tensor Core | NVIDIA Blackwell GPU · Tensor Cores Gen5 (hỗ trợ FP4) |
| Hiệu năng AI lý thuyết | Tối đa 1 PFLOPS FP4 (có Sparsity) (~1000 TOPS) |
| Bộ nhớ hệ thống (RAM) | 128GB LPDDR5x Unified Memory (Giao tiếp 256-bit) |
| Băng thông bộ nhớ | 273 GB/s |
| Ổ cứng lưu trữ | 4TB NVMe M.2 2242 (Tích hợp tính năng tự mã hóa phần cứng) |
| Card mạng SmartNIC | ConnectX-7 @ 200 Gbps (2 × Cổng QSFP112) |
| Cổng mạng Ethernet | 1 × RJ-45 10GbE LAN + Wi-Fi 7 |
| Công suất nguồn / TDP chip GB10 | Adapter 240W USB-C PD / Mức TDP chip GB10 ~140W |
| Độ ồn khi Full Load | ~35 dB (Êm ái tuyệt đối cho không gian văn phòng) |
| Hệ điều hành mặc định | NVIDIA DGX OS (Ubuntu Linux ARM64) |
Con số "1000 TOPS" hay xuất hiện trong tên gọi thương mại chính là 1 PetaFLOP FP4 này. Cần đọc kỹ chú thích của NVIDIA: đây là hiệu năng FP4 lý thuyết khi kích hoạt tính năng sparsity. Nó không phải hiệu năng thực tế của mọi workload, và không nên dùng để so sánh trực tiếp với TOPS của thiết bị khác nếu điều kiện đo khác nhau.
Về khối lượng công việc, NVIDIA phân định rõ ba mức: suy luận (Inference) với mô hình tới 200 tỷ tham số, tinh chỉnh (Fine-tune) tới 70 tỷ tham số, và khi ghép hai máy qua ConnectX-7 thì xử lý được với mô hình tới 405 tỷ tham số.
II. DGX Spark phù hợp với doanh nghiệp nào?
DGX Spark hợp với nhóm khách hàng cần chạy mô hình lớn tại chỗ (Local) vì lý do bảo mật dữ liệu hoặc chi phí token, chấp nhận đánh đổi tốc độ để lấy dung lượng bộ nhớ và quyền kiểm soát. Dưới đây là năm nhóm phù hợp nhất:
- Công ty phần mềm và Outsource đang phát triển sản phẩm AI: Đây là tệp khách hàng phù hợp nhất. Đội dev cần môi trường giống production để prototype agent, thử model, chạy thử pipeline trước khi đẩy lên cloud. NVIDIA định vị rõ máy cho "prototyping, fine-tuning, inference" và cho phép chuyển công việc lên DGX Cloud khi cần triển khai thật. Với đội 5–15 dev, một hoặc hai máy DGX Spark rẻ hơn và ổn định hơn việc mỗi người tự trả tiền API.
- Doanh nghiệp có dữ liệu không được rời khỏi công ty: Hồ sơ bệnh án, dữ liệu tài chính, hợp đồng, thiết kế sản phẩm, dữ liệu nhân sự. Từ ngày 01/01/2026, Luật Bảo vệ dữ liệu cá nhân số 91/2025/QH15 đã có hiệu lực. Khi ràng buộc là "dữ liệu không được gửi lên cloud", bài toán không còn là so sánh giá mỗi triệu token nữa — cloud đơn giản là không dùng được. Ổ NVMe 4TB có tự mã hóa hỗ trợ đúng bối cảnh này.
- Nhóm nghiên cứu, Trường đại học, Viện nghiên cứu: Ngân sách theo đề tài, không có phòng server, không có người quản trị hạ tầng chuyên trách. Máy chạy điện dân dụng, độ ồn 35 dB khi tải nặng nên đặt được trong phòng làm việc chung.
- Đội phát triển Robot, Thị giác máy tính (Computer Vision), Camera AI nhà máy: NVIDIA nêu đích danh các framework Isaac, Metropolis và Holoscan chạy trên DGX Spark. Với doanh nghiệp trong khu công nghiệp đang làm bài toán đếm sản phẩm, kiểm tra lỗi bằng camera, hoặc điều khiển robot, đây là môi trường phát triển cùng hệ sinh thái với thiết bị Jetson sẽ triển khai ngoài hiện trường.
- Startup và doanh nghiệp muốn kiểm soát chi phí token: Nếu chi phí gọi API đang tăng đều mỗi tháng và workload chạy liên tục chứ không theo đợt, chuyển sang chạy tại chỗ là bài toán TCO đáng tính. Sicomp khuyến nghị so sánh trên chu kỳ 24–36 tháng, gồm cả điện và công quản trị, chứ không so giá mua đơn thuần.
III. Ai tuyệt đối KHÔNG nên mua DGX Spark?
Phần này quan trọng hơn phần trên. Có bốn trường hợp DGX Spark là lựa chọn sai, và Sicomp khuyên bạn nên chọn hướng đi khác:
- Bạn cần Huấn luyện (Training) mô hình AI từ đầu: DGX Spark là máy để prototype, fine-tune và inference. NVIDIA đặt trần fine-tune ở 70 tỷ tham số. Train một mô hình nền từ con số không là công việc của cụm GPU trong datacenter, không phải của máy để bàn 240W.
- Ưu tiên số một là Tốc độ sinh token (Decode speed): Băng thông bộ nhớ 273 GB/s là nút thắt cổ chai vật lý cứng. Một cỗ PC cắm card RTX 5090 32GB sẽ sinh chữ nhanh hơn từ 3 đến 6 lần ở các mô hình nạp vừa VRAM.
- Công việc chính là Render 3D hoặc Dựng phim: GB10 có RT Core thế hệ 4 nhưng máy được thiết kế cho agentic AI. Với render, một bộ PC Workstation gắn GPU rời cho hiệu năng cao hơn nhiều trên mỗi đồng đầu tư.
- Dự định gom 8–10 máy thành cụm cluster lớn: Công cụ NVIDIA Sync Cluster Assistant chỉ hỗ trợ tối đa 4 máy. Vượt quá con số này, toàn bộ cấu hình mạng phải làm thủ công, và bài toán đã chuyển thành bài toán hạ tầng máy chủ server thực sự — lúc này các hệ thống Server GPU chuyên dụng hiệu quả hơn.
IV. Vì sao 273 GB/s là con số quan trọng nhất trên spec sheet?
Vì với suy luận LLM, tốc độ sinh ra từng từ (token) bị giới hạn bởi **băng thông bộ nhớ (Memory Bandwidth)**, không phải bởi sức tính toán thô. Mỗi token sinh ra, GPU phải đọc lại toàn bộ trọng số mô hình từ bộ nhớ. Băng thông càng thấp, số token mỗi giây càng thấp — bất kể chip mạnh đến đâu.
DGX Spark dùng LPDDR5x giao tiếp 256-bit, cho 273 GB/s. Đặt cạnh một GPU workstation cùng thế hệ Blackwell sẽ thấy rõ khoảng cách:
| Tiêu chí so sánh | NVIDIA DGX Spark (GB10) | NVIDIA RTX PRO 6000 Blackwell |
|---|---|---|
| Dung lượng bộ nhớ | 128 GB LPDDR5x hợp nhất | 96 GB GDDR7 có ECC |
| Giao tiếp bộ nhớ | 256-bit | 512-bit |
| Băng thông bộ nhớ thực tế | 273 GB/s | 1.597 GB/s (Gấp ~6,5 lần) |
| Hiệu năng AI lý thuyết | 1 PFLOP FP4 (Sparse) | 4 PFLOPS FP4 (~4000 TOPS) |
| Công suất tiêu thụ điện | 240W toàn bộ cỗ máy | 600W riêng cho chiếc card |
Băng thông của RTX PRO 6000 Blackwell cao hơn khoảng 6,5 lần. Nghĩa là ở cùng một mô hình vừa với bộ nhớ của cả hai, card rời sẽ sinh token nhanh hơn nhiều lần.
Vậy DGX Spark thắng ở đâu? Ở dung lượng. 128GB bộ nhớ hợp nhất cho phép nạp trọn mô hình 120B/200B mà card 32GB hay 96GB không chứa nổi. Một mô hình chạy 45 tokens/s vẫn hơn một mô hình không chạy được do báo lỗi Out-of-Memory (OOM). Đây chính xác là chỗ đứng của DGX Spark: nó không cạnh tranh về tốc độ sinh chữ đơn luồng, nó mở ra lớp mô hình khổng lồ mà máy để bàn thông thường không đụng tới, trong một chiếc hộp 1,2 kg tiêu thụ 240W.
V. Cần chuẩn bị gì trước khi nối nhiều máy DGX Spark thành Cluster?
NVIDIA đặt bốn điều kiện tiên quyết chung cho mọi cấu hình cluster, thiếu một điều là quá trình cấu hình sẽ hỏng ở bước sau:
- Đồng bộ Username trên tất cả các máy: Cluster Assistant kiểm tra cả username, user ID và group ID; lệch nhau sẽ bị báo lỗi dừng cài đặt.
- Quyền SSH và sudo không hỏi mật khẩu: Kiểm tra bằng lệnh
sudo whoami. - Cập nhật OS và Firmware mới nhất: Đảm bảo tất cả các máy chạy cùng phiên bản DGX OS mới nhất trước khi bắt đầu.
- Sử dụng dây cáp QSFP đúng chuẩn NVIDIA phê duyệt: NVIDIA phê duyệt cụ thể hai mã cáp: Amphenol NJAAKK-N911 (QSFP sang QSFP112, 32AWG, 40cm) hoặc bản 0,5m NJAAKK0006; và Luxshare LMTQF022-SD-R (cáp DAC QSFP112 400G, 40cm, 30AWG). Cổng QSFP chỉ hỗ trợ chế độ Ethernet.
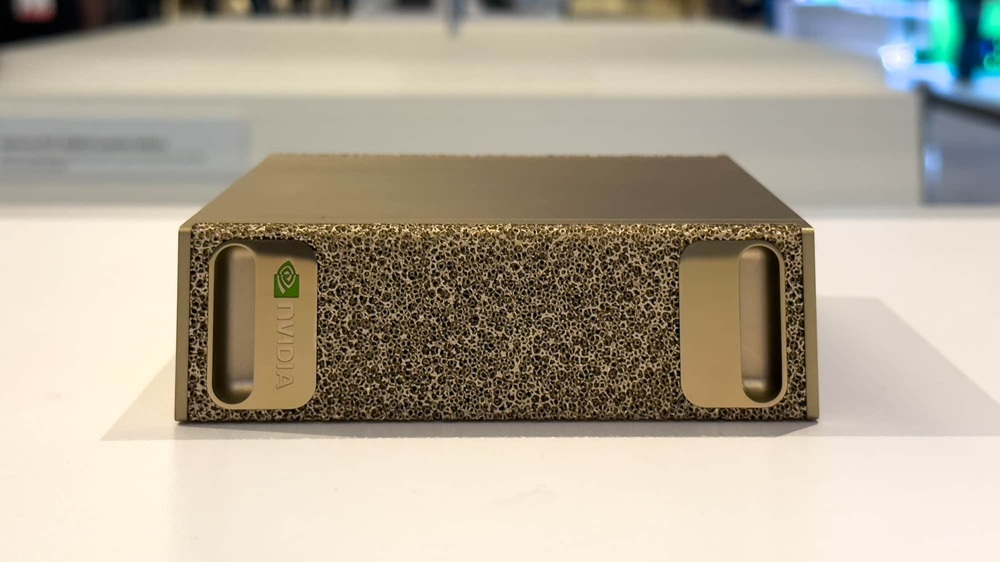
Cơ chế hiển thị interface mạng ConnectX-7: NIC ConnectX-7 nối vào SoC qua hai đường PCIe Gen 5 x4 độc lập. Hậu quả là mỗi cổng QSFP vật lý hiện lên thành hai interface Ethernet riêng biệt trong Linux, mỗi interface lại có một interface RoCE tương ứng. Cắm một cáp, bạn thấy bốn tên interface. Cắm hai cáp, bạn thấy tám. Đây là hành vi phần cứng bình thường, không phải lỗi.
VI. Cách kết nối 2 máy DGX Spark thế nào?
Hai máy nối trực tiếp bằng một sợi cáp QSFP duy nhất, hoàn toàn không cần switch. Đây là cấu hình đơn giản nhất và đạt hiệu năng tối ưu nhất.
- Bước 1 — Đồng bộ Username: Đảm bảo hai máy dùng chung một tên tài khoản quản trị.
- Bước 2 — Cắm cáp vật lý: Nối một sợi cáp DAC QSFP112 giữa hai máy, lẫy gạt (pull-tab) hướng lên trên. Sau khi cắm, chạy lệnh
ibdev2netdevđể kiểm tra interface nào đã kích hoạt trạng thái (Up). - Bước 3 — Cấu hình Netplan IP: Tạo file netplan trên cả hai máy với dải link-local hoặc gán IP tĩnh (ví dụ máy 1 dùng 192.168.100.10/24 và máy 2 dùng 192.168.100.11/24) rồi gõ
sudo netplan apply. - Bước 4 — Bật SSH không cần mật khẩu: Chạy script tự động
bash ./discover-sparksdo NVIDIA cung cấp hoặc thiết lập thủ công bằngssh-copy-id. - Bước 5 — Kiểm tra thông mạng: Chạy lệnh
ssh <IP máy còn lại> hostnametừ mỗi máy. Trả về đúng tên máy là cluster 2 node đã sẵn sàng.
VII. Cách kết nối 3 máy theo Ring Topology?
Ba máy nối trực tiếp theo vòng khép kín (Ring Topology), sử dụng 3 sợi cáp QSFP — mỗi máy dùng cả 2 cổng QSFP của nó để nối tới hai máy còn lại. Đây là cấu hình nối trực tiếp tối đa mà không cần trang bị Switch chuyên dụng.
Với ba máy, mỗi máy đã tận dụng hết sạch hai cổng QSFP vật lý sẵn có. Điều này đồng nghĩa với việc bạn đã đụng trần giao tiếp phần cứng — và đó chính là lý do vật lý khiến cấu hình bốn máy không thể cắm trực tiếp được nữa.
VIII. Vì sao 4 máy bắt buộc phải có Switch?
Vì mỗi DGX Spark chỉ có hai cổng QSFP. Trong cấu hình nối trực tiếp mesh hoàn chỉnh, bốn máy cần mỗi máy nối tới ba máy còn lại — tức cần 3 cổng vật lý trên mỗi máy. Phần cứng không đủ cổng, nên NVIDIA nêu thẳng trong tài liệu Cluster Assistant: cấu hình nối trực tiếp chỉ hỗ trợ 2 máy và 3 máy. 4 máy trở lên bắt buộc phải đi qua Switch.
Hạ tầng cần chuẩn bị thêm cho cụm 4 máy:
- Một Managed Switch QSFP tốc độ cao, có ít nhất 4 cổng QSFP56-DD (mỗi cổng tối thiểu 200 Gbps).
- Bốn sợi cáp QSFP — một sợi từ mỗi máy cắm về Switch.
- Kỹ sư vận hành phải biết cách quản trị Switch: bật/tắt cổng QSFP, tạo software bridge, và đặt tốc độ link thủ công kèm tắt auto-negotiation.
IX. Bảng tổng hợp Topology theo số lượng máy
| Số máy | Kiểu kết nối mạng | Số lượng cáp | Cần Switch? | Cluster Assistant hỗ trợ? |
|---|---|---|---|---|
| 2 máy | Nối trực tiếp (Direct) | 1 sợi | Không cần | Có (Tự động) |
| 2 máy | Qua Switch | 2 sợi | Có | Có |
| 3 máy | Vòng Ring trực tiếp | 3 sợi | Không cần | Có (Tự động) |
| 3 máy | Qua Switch | 3 sợi | Có | Có |
| 4 máy | Chỉ cắm qua Switch | 4 sợi | BẮT BUỘC CÓ SWITCH | Có |
| Trên 4 máy | Qua Switch Datacenter | 1 cáp/máy | BẮT BUỘC CÓ SWITCH | Không (Phải làm thủ công) |
X. Lỗi thường gặp khi dựng Cluster DGX Spark
- Cắm hai cáp giữa hai máy để mong nhanh gấp đôi: Không nhanh hơn. NVIDIA khẳng định một cáp đã đủ băng thông 200Gbps. Cắm hai cáp buộc bạn phải gán IP cho cả bốn interface mới đạt được băng thông đầy đủ.
- Nhầm Interface do không đọc
ibdev2netdev: Vì một cổng vật lý hiện thành hai interface Linux, gán IP nhầm interface là lỗi rất dễ mắc. Luôn chỉ dùng interface có trạng thái (Up). - Dùng cáp không đúng chuẩn phê duyệt: Cổng QSFP của DGX Spark chỉ chạy chế độ Ethernet. Dùng cáp ngoài danh sách phê duyệt có thể khiến link không đàm phán được đủ 200 Gbit/s, và bài test tốc độ sẽ không qua ngưỡng 184 Gbit/s.
- Để lưu lượng quản trị chạy chung đường ConnectX-7: Máy đã có sẵn cổng Ethernet 10 GbE cho SSH và quản trị hệ thống. Bắt buộc phải tách bạch: quản trị đi qua cổng 10 GbE, còn đường ConnectX-7 chỉ dành cho lưu lượng cluster.
- Username khác nhau giữa các máy: Lỗi này không chặn được ngay ở bước cấu hình mạng nhưng sẽ gây rắc rối khi chạy workload phân tán về sau.
- Đặt máy xa nhau rồi mới đặt mua cáp: Cáp được duyệt chỉ dài 40 cm và 50 cm. Hãy chốt vị trí đặt máy trước khi lên đơn hàng.
XI. Đánh giá nhà cung cấp trước khi xuống tiền
Với thiết bị thuộc nhóm này, phần dịch vụ sau bán hàng đáng cân nhắc ngang phần cứng, vì máy thường nằm trong đường găng tiến độ của một dự án đang chạy. Doanh nghiệp nên hỏi rõ nhà cung cấp ba điểm, yêu cầu trả lời bằng văn bản:
- Bảo hành tại nơi sử dụng hay phải mang máy về? Với thiết bị đang chạy workload liên tục, thời gian máy rời khỏi công ty là thời gian dự án dừng.
- Có máy dùng tạm trong thời gian chờ xử lý sự cố không?
- Cam kết thời gian phản hồi kỹ thuật khi có sự cố là bao lâu?
Chính sách hậu mãi đặc quyền cho khối doanh nghiệp tại Sicomp: Bảo hành 12 tháng tận nơi sử dụng trong bán kính 15km từ trụ sở; hỗ trợ cho mượn thiết bị tạm trong thời gian xử lý; phản hồi trong 30 phút giờ hành chính và đề xuất hướng xử lý trong 1 giờ.
XII. Tổng kết
DGX Spark là thiết bị có định vị hẹp nhưng cực kỳ rõ ràng. Nó không phải máy nhanh nhất, và băng thông 273 GB/s là giới hạn cần chấp nhận từ đầu chứ không phải vấn đề chờ bản cập nhật driver. Thứ nó đổi lại là 128GB bộ nhớ hợp nhất trong một chiếc hộp 1,2 kg chạy điện dân dụng — đủ để mở ra lớp mô hình mà máy để bàn thông thường không chạm tới, và dữ liệu không rời khỏi công ty.
Về mở rộng: hai máy nối trực tiếp một cáp, ba máy nối ring ba cáp, bốn máy bắt buộc qua switch. Con số bốn cũng là trần hỗ trợ của công cụ tự động — vượt qua nó, bạn đã bước sang bài toán hạ tầng server chuyên biệt khác.
Quý doanh nghiệp đang cân nhắc số lượng máy và topology phù hợp cho bài toán AI Local của mình? Đội ngũ kỹ sư của Sicomp sẵn sàng rà soát workload thực tế và tư vấn phương án dựng cluster tối ưu TCO nhất. Hãy liên hệ ngay hotline 0384.734.666 để được hỗ trợ chuyên sâu hôm nay!
Bài viết liên quan
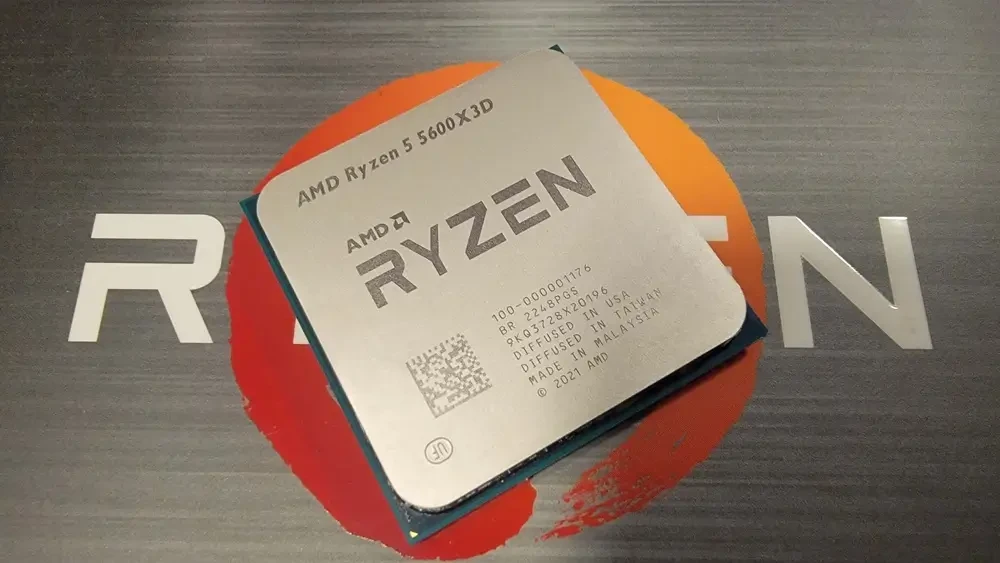
5600X3D ra mắt: lựa chọn rất tốt trong thời điểm gần cuối 2026
Nền tảng Socket AM4 của AMD tiếp tục đưa ra các sản phẩm mới hỗ trợ cho các cá nhân đang muốn nâng cấp cho PC cũ của mình. Mặc dù AM5 đã phổ biến, việc AMD bổ sung các dòng vi xử lý tích hợp công nghệ bộ nhớ đệm xếp chồng 3D V-Cache xuống phân khúc phổ thông như AMD Ryzen 5 5600X3D mang lại một con đường nâng cấp kinh tế hoàn hảo cho game thủ và người dùng đang sở hữu các đời mainboard AM4 cũ. Sở hữu 6 nhân 12 luồng xử lý, tiến trình 7nm TSMC cùng bể chứa bộ nhớ đệm L3 Cache khổng lồ lên tới 96MB, con chip này sẽ là một lựa chọn tốt trong các tựa game eSports mà không đòi hỏi người dùng phải bỏ ra quá nhiều tiền cho 5700X3D. Sicomp sẽ phân tích chiếc CPU này, để chúng ta cùng hiểu tại sao AMD lại phải sản xuất ra chiếc CPU này.
AMD giới thiệu máy workstation Halo Station với tổng VRAM lên đến 576GB
Tại sự kiện công nghệ IFA 2026 tại Berlin, AMD đã làm chấn động toàn bộ ngành công nghiệp phần cứng khi chính thức vén màn siêu cỗ máy mang tên Threadripper Halo Station, được Phó chủ tịch cấp cao Jack Huynh khẳng định là "máy trạm cá nhân mạnh nhất thế giới hiện nay".
Bo Mạch Chủ Có Thể Tăng Giá Do Chi Phí Linh Kiện Tăng
Thị trường linh kiện phần cứng máy tính chuẩn bị bước vào một chu kỳ biến động giá mới khi chi phí nguyên vật liệu sản xuất bo mạch chủ (mainboard) ghi nhận mức tăng kỷ lục từ 10% đến 50%. Theo báo cáo từ chuỗi cung ứng Board Channels, chi phí danh mục vật liệu (BOM) sản xuất bo mạch chủ đã tăng tổng thể ít nhất 10%, trong khi mức điều chỉnh giá bán lẻ mà các hãng áp dụng ra thị trường trong tháng 8 vừa qua chỉ mới bù đắp được khoảng 3%. Sự chênh lệch lớn này cho thấy các nhà sản xuất lớn như ASUS, GIGABYTE, MSI đang chịu áp lực biên lợi nhuận đè nặng và một đợt tăng giá trên diện rộng trong Quý 3 và Quý 4 năm 2026 là điều khó tránh khỏi. Bài viết phân tích từ đội ngũ chuyên gia của Sicomp sẽ bóc tách chi tiết các tác nhân đẩy giá và đưa ra lời khuyên mua sắm tối ưu nhất cho người dùng.
Cách Chọn & Kiểm Tra Trước Khi Mua RAM RDIMM DDR5 64GB 6400
Từ đầu năm 2026, các nhà cung cấp dịch vụ đám mây và các nhà sản xuất máy chủ OEM đã đồng loạt dịch chuyển đơn đặt hàng từ module 96GB và 128GB xuống module 32GB và 64GB, trong khi giá hợp đồng server DRAM quý 3/2026 được dự báo tăng 13–18% so với quý trước (theo TrendForce, 09/07/2026). Hai chuyển động của thị trường gặp nhau ở một điểm: RAM RDIMM DDR5 64GB 6400. Chọn đúng một thanh 64GB tốc độ 6400 MT/s phụ thuộc trực tiếp vào ba yếu tố: cách tổ chức chip nhớ (x4 hay x8), nền tảng của bạn có chạy nổi xung nhịp 6400 ở cấu hình sắp cắm hay không, và module đó đã vượt qua kiểm định QVL của ai. Bài viết này Sicomp sẽ đi qua cả ba vấn đề cốt lõi, kèm bảng tra cứu để bạn kiểm tra chính xác trước khi mua.